Révision du chapitre
1.
Quelle option explique le mieux l'importance du consentement éclairé lors de la phase de collecte de données ?
-
S'assurer que les individus sont conscients des risques et avantages potentiels de la recherche
-
Contourner les réglementations et directives légales
-
Collecter des données à l'insu des individus
-
Accélérer le processus de collecte de données
2.
Qui est responsable de l'obtention du consentement éclairé auprès des individus ou des entreprises avant de collecter leurs données ?
-
Les analystes de données
-
Les agences gouvernementales
-
Les professionnels de santé
-
Les scientifiques des données
3.
Parmi les propositions suivantes, quel principe éthique important convient-il de prendre en compte lors de la phase de collecte de données ?
-
Maximiser les données collectées
-
Minimiser le consentement éclairé
-
Garantir des protocoles d'accès et de stockage sécurisés
-
Éviter de se conformer aux réglementations et directives
4.
Quelle pourrait être une conséquence grave d'une violation de la sécurité des données au cours du processus de développement d'un projet de science des données ?
-
L'accès non autorisé à des informations sensibles
-
L'altération ou la destruction de données
-
Le risque de poursuites judiciaires
-
Toutes les réponses ci-dessus
5.
Comment les organisations peuvent-elles atténuer le risque de violation de données au cours du processus de développement ?
-
Mettre en place des politiques et des protocoles rigoureux de sécurité des données
-
Répondre aux violations de données en temps opportun
-
Utiliser uniquement des données accessibles au public
-
Partager des données avec des tiers sans autorisation
6.
Parmi les propositions suivantes, quelles sont les sources de données valables pour un projet de science des données ? Sélectionnez toutes les réponses qui s'appliquent.
-
Les jeux de données publics
-
Les bases de données privées provenant de sources non affiliées
-
Les dépôts ouverts tels que Kaggle.com et OpenML
-
Toutes les réponses ci-dessus
7.
Quel type de données peut être partagé dans un projet de science des données ?
-
Données quantitatives et qualitatives uniquement
-
Données tabulaires, textuelles et d'images uniquement
-
Données audio uniquement
-
Données quantitatives, qualitatives, tabulaires, textuelles et audio
8.
À qui doit-on donner accès aux données dans un projet de science des données ?
-
Toute personne directement impliquée dans le projet
-
Les actionnaires et les clients uniquement
-
Toute personne directement impliquée dans le projet et ayant un besoin légitime d'accéder aux données
-
Toute personne disposant d'une adresse courriel valide
9.
Quel département est responsable de la conformité réglementaire au sein d'une organisation ?
-
Ressources humaines
-
Marketing
-
Équipes juridiques et de conformité
-
Production
10.
Quel est l'objectif principal de la prise en compte de la justice et de l'équité dans les modèles d'apprentissage automatique ?
-
Augmenter l'exactitude du modèle en évitant les biais
-
Éviter les ennuis juridiques
-
Améliorer l'interprétabilité du modèle
-
Se concentrer sur un seul groupe de données utilisé lors de l'entraînement
11.
Une nouvelle plateforme de médias sociaux cherche des moyens d'améliorer son algorithme de diffusion de contenu afin qu'il s'adresse à un public plus large. Actuellement, la plateforme est principalement utilisée par des étudiants universitaires. Lequel de ces jeux de données serait le plus approprié à collecter et à analyser pour améliorer l'algorithme et réduire le biais potentiel dans le modèle de diffusion de contenu ?
-
Le jeu de données 1, composé de toutes les données de navigation passées sur la plateforme
-
Le jeu de données 2, les résultats d'une vaste enquête menée auprès de personnes issues de divers horizons et segments démographiques, qui connaissent ou non la nouvelle plateforme de médias sociaux
-
Le jeu de données 3, les résultats d'un questionnaire interne à l'entreprise
12.
Quel type de données serait considéré comme une valeur aberrante dans les modèles d'apprentissage automatique ?
-
Des points de données bien représentés dans l'ensemble d'entraînement
-
Des points de données rares ou anormaux par rapport au reste des données
-
Des points de données répartis équitablement entre toutes les classes
-
Des points de données systématiquement étiquetés de manière incorrecte
13.
Pourquoi est-il important de surveiller et de tester régulièrement les algorithmes pour détecter tout biais potentiel ?
-
Pour s'assurer que les modèles ne sont pas en surapprentissage
-
Pour maintenir l'exactitude du modèle
-
Pour garantir l'équité et la justice dans le processus de prise de décision
-
Pour éviter des conséquences juridiques
14.
L'équipe des admissions d'une grande université souhaite mener des recherches sur les facteurs qui contribuent le plus à la réussite des étudiants, améliorant ainsi son processus de sélection des nouveaux étudiants. Le jeu de données qu'elle prévoit d'utiliser comporte des caractéristiques numériques telles que la moyenne générale du secondaire (GPA) et les résultats à des tests standardisés, ainsi que des caractéristiques catégorielles telles que le nom, l'adresse, l'adresse courriel et la pratique d'activités sportives ou d'autres activités parascolaires. L'analyse des données sera effectuée par une équipe comprenant des étudiants travailleurs. Lesquelles de ces caractéristiques doivent être anonymisées avant que les étudiants travailleurs ne puissent commencer à travailler ?
-
Le nom, l'adresse et l'adresse courriel
-
La moyenne générale du secondaire et les résultats à des tests standardisés
-
Les activités sportives et parascolaires
-
Aucune des données ne devrait être anonymisée
15.
Dans quelle situation des données peuvent-elles être anonymisées même si elles relèvent de droits de propriété intellectuelle ?
-
Lorsque l'individu a donné son consentement pour l'anonymisation
-
Lorsque les données sont utilisées à des fins de recherche
-
Lorsqu'il existe une menace potentielle pour la sécurité nationale
-
Lorsque les données seront utilisées à des fins de marketing
16.
L'attribution des sources de données favorise la confiance et la transparence en :
-
Identifiant les erreurs et biais potentiels dans les données
-
Permettant à d'autres de reproduire les résultats
-
Protégeant la vie privée et la dignité des individus
-
Toutes les réponses ci-dessus
17.
L'application des principes de conception universelle dans la visualisation de données et l'attribution des sources de données permet de garantir que les personnes de quel groupe sont en mesure de visualiser et d'utiliser les données ?
-
Les personnes ayant des déficiences visuelles
-
Les personnes ayant des déficiences cognitives
-
Les personnes ayant des déficiences auditives
-
Toute personne qui utilisera les données
18.
Quel terme est utilisé pour créditer et reconnaître correctement les sources de données en science des données et en recherche ?
-
Attribution des données
-
Manipulation des données
-
Exactitude des données
-
Extraction de données
19.
Quelle est l'une des responsabilités éthiques des scientifiques des données et des chercheurs lors de la présentation des données ?
-
Maximiser les profits
-
Manipuler les données pour les faire correspondre au récit souhaité
-
Garantir l'accessibilité et l'inclusivité
-
Suivre les dernières tendances en matière de techniques de visualisation de données
20.
Au département de l'Environnement et de l'Agriculture, les niveaux croissants de CO₂ dans l'atmosphère suscitaient une inquiétude grandissante. Il était évident que les activités humaines, en particulier la combustion d'énergies fossiles, constituaient la cause principale de cette augmentation. Le département a chargé une équipe de scientifiques des données d'étudier les conséquences potentielles sur les régimes climatiques aux États-Unis. Ils ont analysé l'évolution des émissions de CO₂ au fil des ans et ont constaté une hausse marquée ces derniers temps. L'équipe a simulé divers scénarios à l'aide de modèles climatiques et a prédit que si la tendance actuelle se poursuit, les conséquences sur le climat seront désastreuses. Les quatre graphiques présentés dans la Figure 8.11 illustrent le même jeu de données traité par quatre chercheurs différents. Parmi ces quatre graphiques, lequel représente fidèlement les données relatives au CO₂ sans aucune distorsion ni déformation ?
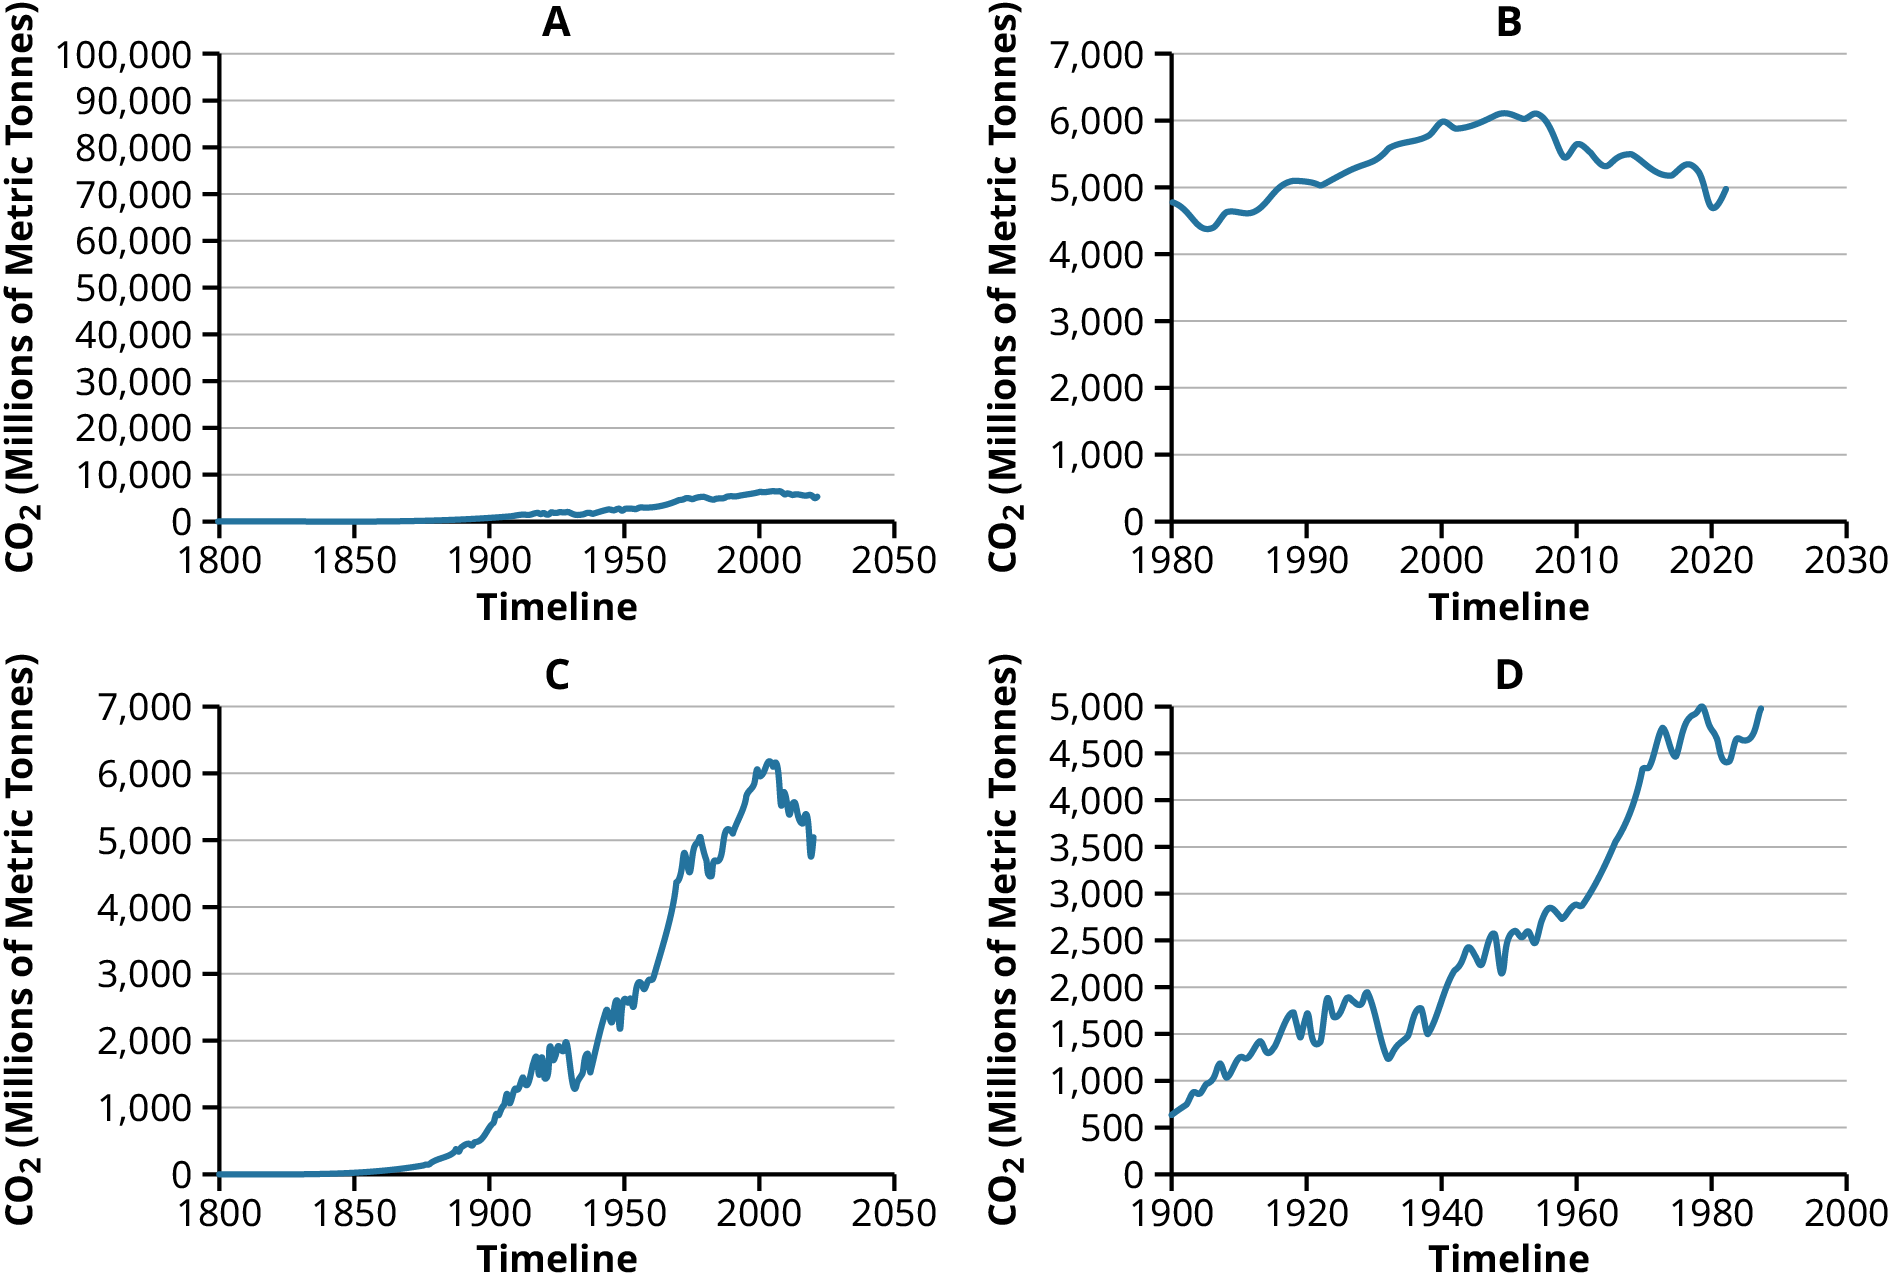
Figure 8.11 Source : Hannah Ritchie, Max Roser et Pablo Rosado (2020) - « CO₂ and Greenhouse Gas Emissions ». Publié en ligne sur OurWorldInData.org. Extrait de : 'https://ourworldindata.org/co2-and-greenhouse-gas-emissions' [Ressource en ligne]
-
Graphique A
-
Graphique B
-
Graphique C
-
Graphique D